ビジネス文書、データベース管理、そしてWebサイトの運用現場において、頻繁に直面する課題が「重複(ちょうふく・じゅうふく)」という現象です。同じデータが複数存在したり、同一の内容が意図せず二重に登録されたりすることで、業務効率の低下やシステムの誤作動、さらには検索エンジン最適化(SEO)における評価の分散といった様々な問題を引き起こします。
本記事では、重複の正しい読み方や意味をはじめ、ビジネス、IT、SEOの各領域における具体的な原因とトラブル事例、そして実務で役立つ効果的な対策やチェックの仕組みについて網羅的に解説します。
「重複」の正しい読み方と意味とは?言葉の基本を整理
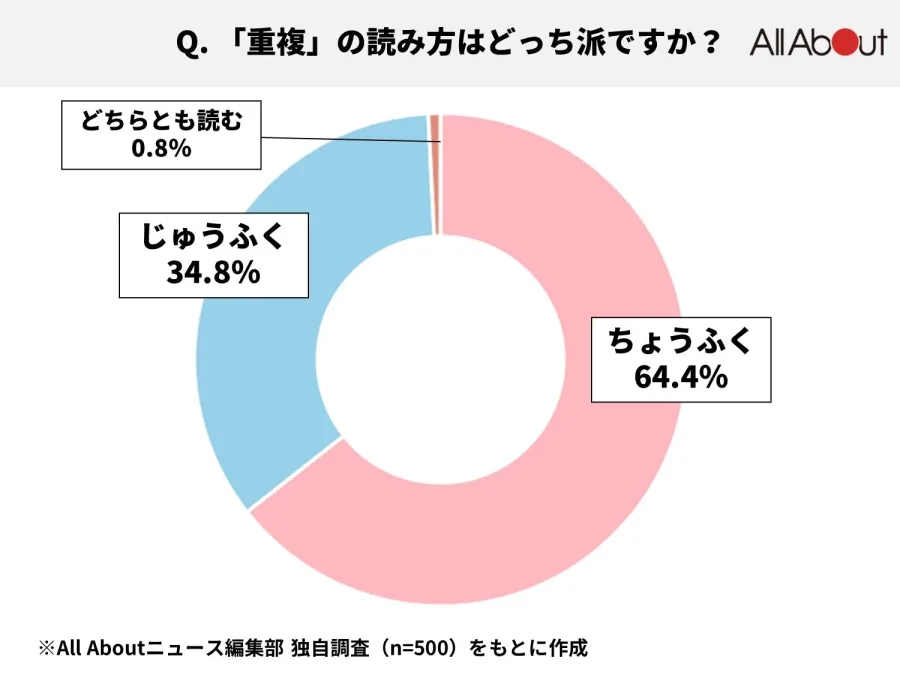
まずは言葉の定義から確認していきましょう。「重複」とは、同じような事柄や物事が二重以上に重なり合っている状態を指す言葉です。日常会話からビジネス文書まで幅広く使用されていますが、読み方については長年議論されることが多いポイントでもあります。
国語辞典などの規範的な表記では、本来の正しい読み方は「ちょうふく」とされています。しかし、漢字の「重(じゅう)」という音読みの浸透や言いやすさから、「じゅうふく」という読み方も「慣用読み」として広く認められており、現代のビジネスシーンではどちらを使用しても意味が通じないということはほとんどありません。ただし、アナウンサーや公的な文書、厳格な法務文書などでは本来の「ちょうふく」が好まれる傾向にあります。
ビジネスシーンにおける重複の具体例と業務への影響
日々のオフィスワークにおいて、データの重複はさまざまなトラブルの火種となります。代表的な例として挙げられるのが、顧客管理システム(CRM)や名刺管理ツール、営業支援ツール(SFA)への「重複登録」です。
同じ顧客の情報が担当者違いで別々に登録されてしまうと、以下のような弊害が生じます。
- アプローチの重複:同一の顧客に対して複数の営業担当者が同時に連絡を入れてしまい、企業としての信頼性が低下する。
- データ分析の精度低下:売上データや顧客数が実態よりも水増しされ、正確なマーケティング分析や売上予測が立てられなくなる。
- ストレージと管理コストの無駄:不要なデータが肥大化することにより、システムの検索性が悪化し、メンテナンスに余計な工数がかかる。
これらの実務上のミスを防ぐため、多くの企業では定期的なデータのクレンジング作業や、入力時のバリデーションチェックを義務付けています。
ITシステム・データベース・エラーにおける重複の仕組み
情報システムやデータベースの構築において、データの重複は致命的な不具合や「重複エラー」を引き起こす原因となります。システム開発や運用現場でどのように扱われているのか、その仕組みを整理します。
データベース設計では、各レコードを識別するために「主キー(プライマリキー)」や「ユニーク制約(一意性制約)」という仕組みが用いられます。例えば、会員登録システムにおいてメールアドレスにユニーク制約を設定しておけば、すでに登録されているアドレスで新規登録を行おうとした際に、システムが自動的に「重複エラー」を検知し、登録を拒否します。
| 領域・シーン | 主な重複の発生原因 | 具体的な影響・エラー | 推奨される対策 |
|---|---|---|---|
| ビジネス・顧客管理 | 手動入力時のヒューマンエラー、担当者間の情報共有不足 | 顧客への二重アプローチ、売上データの錯綜 | マスターデータの統合、ルール化、名寄せ作業 |
| IT・データベース | ユニーク制約の未設定、外部連携時のデータインポートミス | 重複エラーの発生、システム処理の遅延・不整合 | 一意性制約の設定、バリデーションの強化 |
| Web制作・SEO | 同一内容のページ複数作成、URLパラメータの未整理 | 検索エンジンの評価分散、クロールバジェットの無駄遣い | canonicalタグの設定、301リダイレクト、重複ページの統合 |
SEOにおける「重複コンテンツ」の脅威と検索順位への影響
Webサイトやオウンドメディアを運営する上で特に注意しなければならないのが、SEOにおける「重複コンテンツ(デュプリケイト・コンテンツ)」の問題です。検索エンジン(Googleなど)は、ユーザーにとって価値が高く、オリジナリティのある情報を優先して評価する仕組みを持っています。
もし、サイト内に全く同じ内容、あるいは極めて似通った内容のページが複数存在すると、検索エンジンはどのページをインデックスし、どれを上位表示させるべきか迷ってしまいます。その結果、以下のような悪影響が生じます。
- 評価の分散:本来1つのページに集まるはずだった被リンクや検索評価が複数のURLに分散し、どちらのページも上位表示されにくくなる。
- クロールの非効率化:検索エンジンのクローラーが重複した巡回にリソースを割いてしまい、重要度の高い新着ページがインデックスされにくくなる。
- ペナルティのリスク:悪質なコピーコンテンツとみなされた場合、サイト全体の評価が押し下げられる要因となる。
ECサイトにおける商品の色違いやサイズ違いのページ、PC用とスマホ用でURLが完全に分かれている場合などに起こりやすいため、適切な技術的処置が不可欠です。
データ重複を防ぐための仕組みと実務で役立つ対策
重複トラブルを根本から防ぎ、業務効率やWebサイトの品質を保つためには、事前の仕組みづくりと実務に即した対策が不可欠です。領域ごとに有効なアプローチを見ていきます。
1. IT・データベースにおける対策システム開発の段階で、データベースに「一意性制約(ユニークインデックス)」を必ず付与し、プログラム側でも入力値の重複チェック(バリデーション)を厳格に行うことが基本です。また、定期的に既存データを解析し、類似データを統合する「名寄せ(なよせ)」のバッチ処理を組み込むことも有効です。
2. Web・SEOにおける対策類似・重複するページが存在せざるを得ない場合は、検索エンジンに対して正しい情報を伝えるためのタグを活用します。
- Canonicalタグ(カノニカルタグ):複数の類似ページの中から、検索エンジンに評価させたい「メインのURL」を指定し、評価の集中を図る。
- 301リダイレクト:古いURLから新しいURLへ自動転送する仕組みを使い、ユーザーとクローラーを適切に誘導する。
- 適切なサイト構造の設計:コピペによる量産を避け、各ページに独自の価値や情報を盛り込む。
【重複とは】に関するよくある質問(FAQ)
Q1:ビジネス文書やメールで「重複」を使う際、正しい読み方は「ちょうふく」と「じゅうふく」のどちらですか?
A1:本来の正しい日本語としての規範は「ちょうふく」ですが、現代では「じゅうふく」も慣用読みとして広く定着しており、日常のビジネス会話やメールで使っても間違いではありません。ただし、公式なスピーチや厳格な公文書では「ちょうふく」を使用するのが無難です。
Q2:エクセル(Excel)でデータの重複を効率的に見つけて削除する方法はありますか?
A2:Excelには標準で重複データを管理する機能が備わっています。確認したいデータ範囲を選択し、「データ」タブにある「重複の削除」機能を実行するか、「ホーム」タブの「条件付き書式」から「セルの強調表示ルール」>「重複する値」を選択することで、視覚的に重複箇所を特定し、素早く整理することができます。
Q3:SEOにおける重複コンテンツは、サイト全体の評価に悪影響を与えますか?
A3:直接的なペナルティを受けるケースは稀ですが、検索エンジンが評価を分散させてしまうため、本来得られるはずのトラフィックや検索順位を獲得できなくなる大きな要因となります。Canonicalタグの設置やリダイレクトを活用して、検索エンジンに正しい評価軸を伝えることが重要です。
「重複」という現象は、文字の読み方や意味の解釈といった基礎的な部分から、企業のデータベース管理、さらにはWebマーケティングにおけるSEO評価にいたるまで、あらゆる実務の現場に深く関わっています。
単なる「ミスの放置」として片付けるのではなく、システム的な入力チェックの導入、データベースの定期的なクレンジング、そしてWebサイトにおける適切なタグ設定など、構造的な対策を講じることが何よりも大切です。本記事で解説したポイントを参考に、日々の業務やサイト運営における重複リスクを見直し、効率的で精度の高い環境づくりを進めていきましょう。